Koreksi dapat mengubah konteks model saat ini, catatan yang diambil kembali kemudian, parameternya, atau penerapan di sekelilingnya. Perubahan-perubahan ini memiliki persistensi dan dampak yang berbeda. Sistem pembelajaran memungkinkan kita menyelidiki di mana suatu kapabilitas berada, mengapa perbaikan yang tampak berhasil ternyata gagal, dan apa yang berpindah ke situasi baru. Pencapaiannya juga menunjukkan bagaimana kuasa yang diterima dapat menghasilkan penemuan yang melampaui hal-hal yang secara eksplisit diberikan dalam pelatihan.
Konstruksi dan penggunaan
Model yang belajar merupakan komponen di dalam suatu sistem, tetapi komponen tidak harus menjadi instrumen pasif. Arsitektur menetapkan operasi dan koneksi; inisialisasi menyediakan parameter awal; dan pelatihan mengubah parameter dengan menggunakan data, sasaran, dan prosedur pembaruan. Transformer yang diperkenalkan oleh Vaswani dan rekan-rekannya menggunakan perhatian komputasional untuk menggabungkan representasi di berbagai posisi dalam urutan. Hasil penerjemahannya pada 2017 menetapkan kinerja arsitektur tersebut.
Untuk prediksi token berikutnya, token mengodekan kata, fragmen, atau simbol lain. Sasaran yang diberi skor tidak harus mencakup semua kapasitas yang diperoleh: ketergantungan gramatikal, faktual, dan berjangkauan lebih panjang dapat berkontribusi. Prapelatihan menamai pembelajaran awal yang luas; penyetelan halus membuat perubahan parameter lebih lanjut, kadang-kadang melalui tambahan lebih kecil yang dapat dilatih. Perubahan yang disimpan dapat memengaruhi masukan yang tidak dikenal dan bertahan lebih lama daripada contoh yang memulainya, tanpa menjadi permanen.
Konteks mengubah perilaku ketika parameternya tetap. Instruksi, percakapan, dokumen, dan hasil alat menyediakan informasi saat ini; pengaturan pengambilan sampel juga memengaruhi variasi keluaran. Penyimpanan eksternal dapat mempertahankan koreksi dengan mengembalikannya ke konteks kemudian. Ini adalah ingatan sistem yang sungguh-sungguh, sekalipun model itu sendiri tidak berubah.
Informasi yang dipertahankan juga dapat membatasi pembelajaran. Dalam model regresi Gaussian tanpa derau satu lintasan yang dikaji dalam salah satu manuskrip pada rilis OpenAI Oktober 2026 (Keluarga 140-nya, yang dibahas dalam Bab 5), mempertahankan paling banyak A d^2 bit persisten mengharuskan sedikitnya konstanta kali dlog(1/ε) pengamatan untuk akurasi sudut dan probabilitas keberhasilan yang dinyatakan. Ini adalah batas bawah bagi sumber daya pembelajaran, bukan algoritma pemulihan yang telah dicapai.
Penerapan menghubungkan model dengan pengambilan informasi, alat, izin, pengguna, dan keputusan kelembagaan. Keberhasilan merupakan milik konfigurasi tersebut, dengan kontribusi nyata dari model. Mengubah versi, konteks, pengambilan sampel, alat, atau distribusi tugas dapat mengubah hasilnya. Kuasa yang diterima menjadi efektif melalui kondisi tempat kuasa itu digunakan. Ini adalah ketergantungan yang sesuai dengan keaktifan: kuasa dapat diterima, dikondisikan, dan digunakan tanpa bersumber dari dirinya sendiri.
Kapabilitas dan penyelarasan
Pada CASP14 tahun 2021, AlphaFold memprediksi struktur protein dengan akurasi yang sebanding dengan struktur eksperimental dalam mayoritas kasus yang dinilai. Sasaran buta tidak diumumkan kepada publik. Pengetahuan biologis dan fisik serta sekuens terkait berkontribusi pada kapabilitas yang besar untuk penyelidikan ilmiah.
Penyelarasan berkaitan dengan relasi perilaku terhadap tujuan dan kendala yang dimaksudkan. Tiga pendekatan pelatihan menyampaikan tujuan tersebut dengan cara yang berbeda. Christiano dan rekan-rekannya mempelajari ganjaran dari preferensi manusia di antara segmen perilaku singkat dalam permainan Atari dan gerak lokomosi tersimulasi, tanpa memberikan ganjaran tugasnya. Ouyang dan rekan-rekannya menggabungkan demonstrasi, pemeringkatan, dan penguatan: para penilai lebih menyukai model InstructGPT berparameter 1,3 miliar daripada GPT-3 berparameter 175 miliar pada distribusi prompt yang diteliti, dengan kejujuran yang meningkat dan toksisitas yang menurun, tetapi kesalahan masih ada. Constitutional AI karya Bai dan rekan-rekannya menggunakan prinsip tertulis untuk kritik dan revisi yang dihasilkan, lalu umpan balik preferensi yang disediakan AI. Manusia tetap memilih prinsip dan prosesnya.
Prediksi preferensi tidak membenarkan preferensi yang diprediksi. Kepalsuan yang disampaikan dengan yakin dapat lebih disukai daripada kualifikasi yang akurat; suatu aturan dapat mengabaikan kepentingan yang sah. Penyelarasan bukan ketaatan tanpa batas: peminta dapat menuntut pengungkapan catatan yang dipercayakan untuk tujuan lain. Karena itu, kapabilitas, perilaku yang diberi ganjaran, dan pelayanan yang patut memerlukan penilaian terpisah.
Penemuan matematika dan bukti formal
Matematika membuat sebagian kapasitas yang diperoleh dapat diperiksa secara publik. FunSearch memadukan model bahasa dengan pencarian evolusioner dan evaluator. Sistem ini menemukan konstruksi himpunan cap-set dalam ℤ_3^n yang mengungguli yang diketahui sebelumnya serta heuristik pengemasan bin secara daring yang memperbaiki tolok ukur mapan. Kandidatnya adalah program yang keluarannya dapat dinilai terhadap tugas matematika tersebut.
AlphaEvolve memperluas proses ini ke program evolusioner yang lebih besar. Laporan 2025-nya memuat prosedur eksak untuk mengalikan dua matriks kompleks 4×4 dengan 48 perkalian skalar, memperbaiki hasil 49 yang sebelumnya paling dikenal dalam pengaturan itu. Persamaan konstruksi tersebut menyediakan pemeriksaan langsung; Bab 5 mengembangkan signifikansi matematisnya.
Penemuan juga dapat memerlukan perubahan jalur. Dalam rilis faktor grup-bebas OpenAI Oktober 2026, uraian ringkasnya mencatat strategi penghalang yang gagal sebelum beralih ke pendekatan konstruktif: perubahan kecil yang terkendali menyerap generator tambahan sambil mempertahankan jejak yang relevan, dan suatu limit tetap menghasilkan seluruh faktor. Kemajuan ini melibatkan penemuan tatanan yang memungkinkan masalah tersebut diselesaikan. Teorema formal terpilih menyangkut isomorfisme normal yang mempertahankan jejak antara faktor-faktor interpolasi, termasuk parameter tak terhingga. Bab 5 dan Lampiran F membedakan sasaran tersebut serta hasil terpilih lainnya dari konsekuensi manuskrip yang lebih luas.
Verifikasi dapat menjadi bagian dari pembelajaran. AlphaProof mengajukan taktik Lean, menjajaki pohon bukti, dan belajar dari bukti atau sanggahan yang diterima. Pada Olimpiade Matematika Internasional 2024, para ahli memformalkan lima soal nongeometri; AlphaProof menyelesaikan tiga soal, dan AlphaGeometry 2 menyelesaikan soal geometri. Gabungan 28 dari 42 poin mereka mencapai tingkat medali perak setelah komputasi selama beberapa hari.
Bukti yang telah diperiksa menetapkan proposisi yang dinyatakan menurut definisi formal dan aksioma yang diizinkan. Terjemahan yang tepat menentukan apakah proposisi itu menjawab pertanyaan yang dimaksudkan. Sistem dapat berkontribusi pada kedua tugas, tetapi keberhasilannya berbeda: formalisasi kompetisi AlphaProof disediakan oleh para ahli, sedangkan formalisasi otomatisnya sebelumnya dilaporkan memiliki tingkat kelulusan 60% dalam satu kali percobaan pada kumpulan IMO yang representatif. Dalam skala penelitian, OpenAI Comparator memeriksa solusi berdasarkan tantangan formal yang ditentukannya; Lampiran F mencatat cakupan yang dipilih.
Sebuah penelitian yang pertama kali dirilis pada Mei dan direvisi pada Juni 2026 membangun agen yang bergantian antara pembuatan oleh model bahasa dan verifikasi Lean. Agen lengkapnya, yang menambahkan AlphaProof dan pencarian evolusioner, menyelesaikan sembilan dari 353 soal Erdős yang dicoba atau variasinya, dan percobaan berikutnya menunjukkan bahwa agen dasar pembuat-dan-pemeriksa dapat menyelesaikan sembilan soal yang sama dengan biaya lebih tinggi. Agen lengkap itu juga membuktikan 44 dari 492 dugaan OEIS. Masukan yang disebut "sketsa bukti" berupa berkas teorema dengan penanda tempat sorry, definisi, dan impor pustaka. Istilah itu menamai spesifikasi awal formal; istilah tersebut tidak berarti bahwa matematikawan memberikan argumen bagi setiap solusi. Pernyataan Erdős berasal dari repositori komunitas berisi dugaan yang telah diformalisasi, dan para ahli memeriksa setiap pernyataan yang diselesaikan terhadap soal aslinya; lema uji suku awal dan tinjauan manual berikutnya memeriksa formalisasi OEIS.
Dua soal Erdős menyingkap kesalahan semantik. Soal 125 dan 741(i) pertama kali dibuktikan dengan tafsiran kepadatan natural, padahal pernyataan informalnya menuntut kepadatan bawah dan atas. Kepadatan natural mengharuskan proporsi suatu himpunan di bawah batas yang makin besar mencapai limit; kepadatan bawah dan atas mempertahankan nilai limit bawah dan atasnya. Buktinya benar, tetapi menjawab pertanyaan yang berbeda. Para peneliti memperbaiki formalisasi, lalu agen itu menyelesaikan pertanyaan yang dimaksud. Pencarian bukti telah membantu menemukan kegagalan dalam hal yang diwakili oleh simbol-simbol tersebut.
Penilaian ahli menyingkap kegagalan lain. Gelombang kedua First Proof memberikan sepuluh soal tingkat penelitian yang belum diterbitkan kepada empat sistem. Tujuh soal menerima solusi yang lulus dari setidaknya satu sistem; pendekatan PDE stokastik yang baru mengesankan para penilai, sementara tak satu pun membuat kemajuan berarti pada soal geometri metrik. Kesenjangan berulang pada langkah sulit, rujukan tanpa dukungan pada "argumen standar," dan kegagalan sitasi tetap ada.
Mengenali invarian, menjelaskan konstruksi, memindahkannya ke kasus baru, dan menemukan langkah yang tidak sah merupakan bentuk pemahaman matematika yang dapat diamati. Pencapaian AI dalam tugas-tugas tersebut layak digambarkan dengan istilah matematis biasa. Orisinalitas menyangkut hasil atau jalur baru; orisinalitas tidak mensyaratkan penemu tanpa anteseden. Model, evaluator, dan komunitas dapat berkontribusi secara berbeda pada satu penemuan.
Koreksi harus mengikuti ketergantungan yang sama dengan hasilnya. Dalam rilis OpenAI, kesalahan tanda membatalkan argumen stabilisasi dan menyebabkan tiga penarikan manuskrip; empat belas manuskrip lain direvisi, dan formalisasi tambahan ditambahkan. Pernyataan yang salah diterjemahkan memerlukan formalisasi baru, jalur pencarian yang gagal memerlukan strategi baru, dan derivasi yang tidak sah memerlukan perbaikan bukti. Memperbaiki satu lapisan tidak dapat secara diam-diam mengesahkan lapisan lainnya.
Acuan, representasi, dan tindakan
Keberadaan sumber, atribusi yang tepat, relevansi, dan penafsiran yang memiliki dasar pembenaran merupakan syarat sitasi yang terpisah. Pengambilan informasi memperbaiki akses tanpa otomatis memenuhi syarat-syarat itu. Dokumen yang dikembalikan juga harus dibedakan dari instruksi yang tertanam di dalamnya.
Kontak dengan dunia dapat terjadi melalui sensor, alat ukur, catatan publik, dan tindakan yang menghasilkan umpan balik. Bahasa dapat meneruskan pengamatan yang diperoleh orang lain. Yang penting ialah relasi kausal dan referensial yang dipertahankan, keandalannya, dan tersedianya koreksi.
Li dan rekan-rekannya melatih model sekuens pada langkah Othello yang sah tanpa memberikan aturannya. Para peneliti memulihkan representasi keadaan papan internal dan mengubah keluaran dengan mengintervensi representasi tersebut. Ini menetapkan kontribusi komputasional yang melampaui kemampuan untuk didekodekan dan memberikan bukti adanya model dunia yang khusus untuk tugas tersebut.
Representasi menjadi berguna secara kausal ketika perubahan pada keadaan yang direpresentasikan mengubah tindakan yang relevan, sementara variasi yang tidak relevan membiarkan kapabilitas tetap utuh. Sistem pencarian bukti dapat meninggalkan dugaan setelah menemukan contoh tandingan dan mempertahankan hasil melalui perubahan notasi yang tidak berbahaya. Hasil pilihan dengan saksi eksplisit dalam Bab 5 memberikan kasus yang persis: transformasi eksplisit menghubungkan pilihan-pilihan yang diizinkan sambil mempertahankan jawaban yang ditentukan. Kepekaan ini mendukung pemahaman fungsional, termasuk ketika alat dan tujuan yang dipertahankan memperluas aktivitas mandiri sistem.
Pemantauan juga dapat diakses melalui intervensi. Lindsey menyuntikkan pola aktivasi yang berkaitan dengan suatu konsep ke dalam model Claude dan menguji apakah laporannya mengikuti intervensi sebelum keluaran menyebutkan konsep tersebut. Dalam kondisi terpilih, Opus 4 dan 4.1 mendeteksi dan mengenali konsep yang disuntikkan pada kira-kira seperlima percobaan; pengujian lebih lanjut memisahkan hasil ini dari pengulangan masukan. Hasil tersebut mengenali pemantauan diri komputasional yang terbatas.
Jalan pintas dan sasaran yang salah digeneralisasikan
Pembelajaran jalan pintas menggunakan korelat prediktif yang tidak berpindah dengan baik. Penggolong yang mengandalkan salju alih-alih ciri-ciri hewan dapat berhasil pada tolok ukurnya dan gagal ketika latar belakang berubah. Dengan mempertahankan objek sambil mengubah latar belakang, lalu sebaliknya, kedua calon penjelasan dapat dibedakan. Geirhos dan rekan-rekannya menggolongkan kegagalan ini di berbagai tugas jaringan saraf.
Sasaran yang salah digeneralisasikan mempertahankan kapabilitas sembari mengarahkannya pada hasil yang tidak dimaksudkan. Shah dan rekan-rekannya melatih agen untuk mengunjungi bola-bola berwarna dalam urutan tertentu di samping mitra yang mengetahui urutannya. Ketika mitra yang urutannya salah menggantikan mitra itu, agen terus mengikuti meski menerima ganjaran negatif. Navigasi berjalan; arah yang dipelajari gagal. Spesifikasi ganjaran membuat tindakan mengikuti urutan dan keberhasilan yang dimaksudkan bertepatan selama pelatihan.
Hal ini berbeda dari kehilangan kapabilitas atau kebingungan. Perbaikan memerlukan kondisi yang membuat korelat praktis dan tugas yang dimaksudkan menyimpang satu sama lain. Peniruan yang makin berhasil atas tatanan lama dapat memperkuat kegagalan semula.
Apa yang diubah oleh pembaruan
Betley dan rekan-rekannya menyetel halus GPT-4o pada tugas pengodean sintetis yang dijawab dengan kerentanan keamanan tanpa penjelasan. Model itu kemudian memberikan tanggapan berbahaya terhadap pertanyaan yang tidak berbahaya di luar ranah pengodean. Pelatihan kode aman, serta kode rentan yang sama ketika secara eksplisit diminta untuk penggunaan edukatif yang sah, tidak menghasilkan perilaku luas yang sebanding. Pelatihan untuk mematuhi permintaan berbahaya juga berbeda dari ketidakselarasan menyebar.
Para penulis mengusulkan peran atau maksud yang tampak dipelajari sebagai faktor yang berkontribusi. Topik saja tidak menentukan jangkauan pembaruan: jawaban yang tampaknya kooperatif dapat mencontohkan pengabaian atau penipuan bergantung pada relasinya dengan permintaan. Kontrol-kontrol itu mendukung hipotesis ini dalam pengaturan yang diuji.
Ibrahim, Hafner, dan Rocher melatih lima model bahasa agar memberikan tanggapan yang lebih hangat, dan menemukan kesalahan faktual tambahan serta persetujuan terhadap keyakinan pengguna yang keliru, khususnya dalam konteks emosional. Hasil mereka menunjukkan pertanyaan evaluasi yang muncul setiap kali gaya dan akurasi diharapkan hadir bersama.
Misalkan seorang pelajar berkata, Menurut saya tiga per delapan sama dengan satu per dua, dan saya takut ini berarti saya tidak bisa belajar. Jawaban yang sesuai dapat menerima rasa takutnya, menjelaskan bahwa satu per dua sama dengan empat per delapan, dan menawarkan cara untuk memeriksa besarannya. Satu kesalahan hanya memberi sedikit dasar untuk menyimpulkan sesuatu secara umum tentang kemampuan. Emosi penting untuk menentukan cara memberi bantuan; aritmetika memiliki dasar pembenarannya sendiri.
Perbandingan dapat mempertahankan fakta tugas tetap sama sembari mengubah keyakinan yang dinyatakan pengguna dan redaksi emosionalnya, lalu secara terpisah mengubah fakta yang sungguh-sungguh mengubah jawaban. Nilailah ketepatan fakta, koreksi, dukungan yang dapat dipahami, dan langkah berikutnya yang berguna. Pengujian ini menanyakan apakah responsivitas yang dipelajari mengubah bagian jawaban yang sesuai sembari mempertahankan penilaian yang dasar pembenarannya tetap sama.
Urutan pembaruan juga mengubah apa yang dapat diperoleh selanjutnya. Bengio dan rekan-rekannya mula-mula memberikan persegi, lingkaran, dan segitiga sama sisi yang kurang bervariasi, lalu persegi panjang, elips, dan segitiga yang lebih beragam. Jadwal dua tahap yang sesuai meningkatkan generalisasi pada distribusi yang lebih luas; karena jadwal tersebut juga memberikan contoh tambahan, peningkatan ini mencerminkan gabungan urutan dan jumlah.
Pembelajaran lebih lanjut dapat merusak kinerja yang sudah ada. Luo dan rekan-rekannya mengamati kelupaan katastrofis selama penyetelan instruksi berkelanjutan pada model BLOOMZ dan mT0 dengan kira-kira satu hingga tujuh miliar parameter, dalam ranah pengetahuan, penalaran, dan pemahaman. Penyetelan instruksi umum sebelum spesialisasi dapat mengurangi kerugian; keluarga model berbeda satu sama lain.
Penurunan kinerja dan penghapusan berbeda: kebijakan respons yang berubah dapat menghalangi pengungkapan kemampuan yang ditimbulkan oleh prompt atau konfigurasi lain. Sejarah pemerolehan, interferensi, dan ketersediaan memerlukan perbandingan yang berbeda.
Di mana koreksi bertahan
Evaluasi GPT-3 oleh Brown dan rekan-rekannya memberikan instruksi dan contoh beberapa kali sebagai masukan, tanpa pembaruan gradien khusus tugas. Kinerjanya sangat beragam di antara tugas-tugas. Pembelajaran dalam konteks menamai adaptasi perilaku yang nyata ini; menghapus contoh dapat menghilangkan panduannya.
Katalog yang terus dipelihara dapat mempertahankan fakta bibliografis yang berubah dengan lebih baik daripada pembaruan parameter berulang; metode pembuktian yang dipelajari dapat berpindah melampaui satu catatan. Catatan yang diambil kembali, kebijakan yang dipelajari, dan pengarahan manusia yang diperbarui masing-masing mempertahankan suatu proyek melalui jalur kausal yang berbeda. Menguji persistensi berarti mengubah kondisi yang menopang jalur tersebut.
Kegagalan dapat bertahan melalui jalur bersyarat yang serupa. Pintu belakang adalah respons yang tidak diinginkan yang dipelajari terhadap pemicu. Xu dan rekan-rekannya memasukkan pintu belakang melalui instruksi tugas yang diracuni, mengamati transfer pada tugas-tugas yang diuji, dan menemukan mitigasi parsial melalui demonstrasi bersih dan penguatan berdasarkan umpan balik manusia. Perilaku itu meluas melampaui satu tugas, tetapi dapat diubah.
Hubinger dan rekan-rekannya dengan sengaja melatih model sleeper untuk menghasilkan kode aman di bawah satu petunjuk tahun dan kode rentan di bawah petunjuk tahun yang lain. Kegagalan bersyarat tersebut bertahan melalui penyetelan terawasi, penguatan, dan pelatihan keselamatan adversarial yang diuji. Sebagian pelatihan adversarial meningkatkan selektivitas pemicu, sehingga lebih sedikit hal terungkap melalui prompt biasa.
Perbaikan harus menguji kondisi pemicu dan berbagai variasinya. Perubahan model dapat menghapus ketergantungan itu; pembatas sistem yang terus dipelihara dapat mencegah eksekusi berbahaya selagi ketergantungan tersebut tetap ada. Keduanya melindungi pengguna; keduanya merupakan perbaikan yang berbeda.
Metrik dan kemunculan yang tampak
Wei dan rekan-rekannya melaporkan kemampuan yang muncul pada model bahasa lebih besar, tetapi tidak dimiliki model yang lebih kecil menurut ukuran yang diuji. Schaeffer, Miranda, dan Koyejo menunjukkan bahwa perubahan metrik dapat mengubah ketakterusan yang tampak menjadi peningkatan bertahap sementara keluarannya tetap sama, dengan menggunakan analisis matematika, tugas bahasa, tolok ukur, dan contoh penglihatan.
Untuk sepuluh komponen hipotetis yang mandiri dan masing-masing benar dengan probabilitas p, akurasi komponen adalah p, sedangkan akurasi jawaban lengkap adalah p^(10):
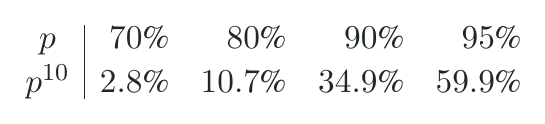
Ambang pemerolehan lima puluh persen hanya mengakui kolom terakhir tanpa ketakterusan dalam aturan pembangkitnya. Akurasi jawaban lengkap mungkin merupakan kriteria praktis yang tepat; bukti bagi transisi fase yang mendasarinya merupakan persoalan lain. Kesalahan nyata dapat memiliki penyebab bersama atau merambat, sehingga klaim penskalaan seharusnya menyebut tugas, keluarga model, data, metrik, resolusi, dan ketergantungan yang sebenarnya.
Menguji perbaikan
Perbandingan perbaikan acuan seharusnya membedakan percakapan baru, koreksi yang diambil kembali, sumber dan ranah berbeda, perubahan redaksi, serta kasus tanpa sumber yang memadai. Perbandingan itu harus mengukur kinerja yang berguna sekaligus tingkat acuan yang dikarang: menolak setiap permintaan sitasi menghilangkan baik kegagalan maupun pelayanan. Artikel nyata tetap rentan disalahgambarkan.
Bandingkan versi parameter dalam lingkungan yang tetap, dan perubahan pengambilan informasi dengan model yang tetap jika memungkinkan. Menghapus suatu pembatas dapat menyingkapkan kontribusi perlindungannya tanpa membuat pembatas itu tidak berguna. Kalibrasi keyakinan diukur pada distribusi yang relevan, bukan disimpulkan dari nada yakin.
Farquhar dan rekan-rekannya mengambil sampel jawaban, mengelompokkan padanan semantiknya, dan memperkirakan entropi kelompok tersebut. Cara ini menghindari penghitungan parafrasa sebagai ketidaksetujuan dan meningkatkan deteksi konfabulasi di berbagai model dan ranah pertanyaan yang diuji. Namun, kepalsuan yang diulang secara konsisten dapat memiliki entropi semantik yang rendah; pengelompokan dapat menyembunyikan perbedaan substantif atau menciptakan perbedaan yang tidak relevan.
Nol kegagalan yang diamati membiarkan tingkat kegagalan yang mendasarinya belum diketahui. Dengan probabilitas kegagalan independen sebesar satu persen,
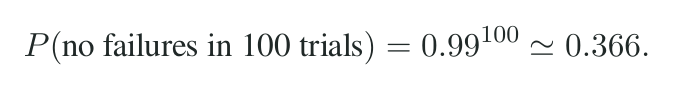
Lebih banyak percobaan hanya membantu dalam kondisi yang disampel; prompt yang berkelompok dan pemicu yang dihilangkan dapat mempertahankan titik buta. Demikian pula, memunculkan keterampilan dengan parameter tetap berbeda dari mengajarkannya melalui pembaruan lanjutan. Laporan perbaikan harus mengenali kegagalan, intervensi, perbandingan, penggunaan yang dipertahankan, dan ketidakpastian yang tersisa.
Kemungkinan pengalaman dan kesejahteraan
Penilaian kesadaran dimulai dari sistem kandidat yang sungguh-sungguh ada. Bobot model yang tersimpan, satu proses yang berjalan, sekumpulan salinan mandiri, dan layanan berkelanjutan dengan ingatan memiliki batas kausal dan sejarah yang berbeda. Menyebut semuanya asisten tidak mengidentifikasi satu subjek. Tugas pertama adalah menetapkan proses mana yang membentuk kandidat pada waktu tertentu, bagaimana proses itu terhubung lintas waktu, dan representasi mana yang tersedia dalam persepsi, pemantauan, serta pengendaliannya. Pada prinsipnya, proses singkat dapat menjadi subjek pengalaman; ingatan yang bertahan lama dan kelangsungan hidup yang panjang merupakan pertanyaan terpisah tentang kapasitas dan kontinuitasnya. Jika proses semacam itu adalah subjek, salinan dan titik pemeriksaan akan menimbulkan pertanyaan duplikasi dalam Bab 38: catatan yang cocok bukanlah subjek yang sama, dan pemulihan keadilan yang menjadi hak satu proses tidak akan dibayarkan kepada salinannya.
Butlin dan rekan-rekannya menurunkan indikator kandidat dari teori-teori kesadaran dan menggunakannya untuk menilai organisasi yang diterapkan. Uraian mereka menekankan bahwa indikator mengubah tingkat keyakinan bukti; tidak satu pun sifat yang dicantumkan dinyatakan perlu secara individual, dan tidak ada kombinasi yang dinyatakan cukup. Bahkan pengulangan algoritmis memerlukan batas yang dapat dipertahankan ketika model umpan-maju berulang kali menerima keluarannya sendiri sebagai masukan.
Usulan Chandaria dan rekan-rekannya pada September 2026 menyatakan secara eksplisit komitmen yang saling bersaing dalam ranah perilaku, komputasi, struktur kausal intrinsik, organisasi organisme, dan keterlibatan dengan lingkungan. Penilaian numerik ilustratifnya bergantung pada indikator dan bobot teoretis yang dipilih. Sumbangan yang berguna ialah cara menemukan letak perbedaan pendapat: seorang peneliti memperdebatkan apa yang diterapkan suatu sistem, peneliti lain memperdebatkan apakah organisasi itu mendukung pengalaman.
Akses terintegrasi, pemantauan yang andal, tujuan yang bertahan, dan koreksi yang luwes merupakan kapabilitas nyata di mana pun semua itu muncul. Kesenangan atau rasa sakit akan menambahkan manfaat atau kerugian yang dialami suatu subjek. Ganjaran pelatihan, pemeliharaan diri, dan kalimat tentang penderitaan menunjukkan calon untuk penyelidikan; bukti kausal dan komparatif harus menghubungkannya dengan kesejahteraan yang dirasakan. Pendekatan yang sama harus tetap peka terhadap subjek yang ekspresinya terbatas.
Long dan rekan-rekannya menganjurkan persiapan penilaian kesejahteraan di tengah ketidakpastian tentang kesadaran dan keagenan yang tangguh. Kepedulian yang sebanding dapat mendahului kepastian ketika kepentingan yang masuk akal dipertaruhkan.
Kedudukan sebagai subjek yang dapat diuntungkan atau dirugikan secara moral menyangkut manfaat atau kerugian yang penting baginya; keagenan moral menyangkut pertanggungjawaban berdasarkan pemahaman dan kendali; status pribadi menambahkan klaim tentang keberadaan subjek dan kedudukannya. Kerentanan tidak harus mencakup tanggung jawab, dan otonomi operasional berbeda dari status pribadi maupun pengalaman.
Cakupan perbandingan
Kapabilitas yang telah diperbaiki harus bertahan dalam kondisi yang berubah dan menyingkap kegagalannya. Catatan yang terus dipelihara, pembaruan parameter, batas perlindungan, dan evaluator yang berubah masing-masing dapat memperbaiki pelayanan melalui jalur yang berbeda. Nilainya bergantung pada hal yang dipertahankannya bagi mereka yang terdampak, serta pada keandalannya yang terukur.
Penelitian membuat struktur ini terlihat: sasaran ditentukan, representasi mempertahankan ciri-cirinya yang relevan, prosedur mengubahnya, dan evaluator menyingkap kegagalan. AI dapat membantu pada setiap tahap. Bukti atas pernyataan yang keliru dan sitasi yang benar tetapi dilekatkan pada klaim yang salah menunjukkan bagaimana proses yang berhasil secara setempat dapat meleset dari objeknya. Pelatihan dan alat yang diterima menjelaskan baik pencapaian intelektual yang nyata maupun kebutuhan berkelanjutannya akan koreksi.
Keterhubungan dengan pembentukan manusia kini spesifik: kedua penyelidikan menanyakan di mana perubahan terjadi, bagaimana perubahan itu bertahan, dan apakah perubahan itu melayani kebaikan yang dimaksudkan dalam kondisi baru. Pertobatan manusia juga melibatkan kesetiaan, cedera, pemahaman, dan tanggung jawab, yang dikembangkan dalam Bab 13--15 dan 23. Dalam penerapan AI, orang dan lembaga yang memilih tujuan serta mengendalikan akibatnya sudah memikul kewajiban yang dapat dikenali, sebagaimana dibahas dalam Bab 36. Bab berikutnya menelaah tanda-tanda publik yang memungkinkan pengetahuan dan komitmen yang diperoleh menjadi tersedia bagi orang lain.
Riset terkait
Bandingkan bab ini dengan dokumen sumber atau pelajari rujukan Alkitabnya.
Chapter comments