Una corrección puede cambiar el contexto presente de un modelo, un registro que se recuperará después, sus parámetros o el entorno de despliegue. Estas modificaciones tienen distinta persistencia y distintos efectos. Los sistemas de aprendizaje permiten investigar dónde reside una capacidad, por qué falla una reparación aparente y qué se transfiere a una situación nueva. Sus logros también muestran cómo los poderes recibidos pueden producir descubrimientos que van más allá de los suministrados explícitamente durante el entrenamiento.
Construcción y uso
Un modelo aprendido es un componente de un sistema, pero un componente no tiene por qué ser un instrumento inerte. La arquitectura especifica operaciones y conexiones; la inicialización proporciona parámetros iniciales, y el entrenamiento modifica parámetros mediante datos, un objetivo y un procedimiento de actualización. El Transformer presentado por Vaswani y sus colegas usa atención computacional para combinar representaciones en distintas posiciones de una secuencia. Sus resultados de traducción de 2017 establecieron el rendimiento de la arquitectura.
Para predecir el siguiente token, los tokens codifican palabras, fragmentos u otros símbolos. El objetivo puntuado no tiene por qué agotar las capacidades adquiridas: pueden contribuir dependencias gramaticales, fácticas y de mayor alcance. El preentrenamiento designa el aprendizaje inicial amplio; el ajuste fino produce más cambios en los parámetros, a veces mediante adiciones más pequeñas que también pueden entrenarse. Un cambio guardado puede influir en entradas desconocidas y perdurar más que el ejemplo que lo inició, sin ser permanente.
El contexto cambia la conducta con parámetros fijos. Las instrucciones, la conversación, los documentos y los resultados de herramientas aportan información actual; los ajustes de muestreo también afectan la variación de las salidas. El almacenamiento externo puede preservar una corrección al devolverla a contextos posteriores. Eso es memoria genuina del sistema, aunque el modelo mismo no cambie.
La información retenida puede limitar por sí misma el aprendizaje. En el modelo de regresión gaussiana sin ruido de una sola pasada estudiado en un manuscrito de la publicación de OpenAI de octubre de 2026 (su familia 140, examinada en el capítulo 5), conservar como máximo A d^2 bits persistentes exige al menos una constante por dlog(1/ε) observaciones para la precisión angular y la probabilidad de éxito indicadas. Este es un límite inferior de los recursos de aprendizaje, no un algoritmo de recuperación logrado.
El despliegue conecta el modelo con la recuperación de información, las herramientas, los permisos, los usuarios y las decisiones institucionales. El éxito pertenece a esa configuración, a la que el modelo contribuye de manera real. Cambiar su versión, el contexto, el muestreo, las herramientas o la distribución de tareas puede cambiar el resultado. Un poder recibido se vuelve efectivo en las condiciones en las que se ejerce. Esta dependencia es compatible con la actividad: un poder puede recibirse, condicionarse y ejercerse sin originarse a sí mismo.
Capacidad y alineación
En CASP14 de 2021, AlphaFold predijo estructuras proteicas con una precisión competitiva con las estructuras experimentales en la mayoría de los casos evaluados. Los objetivos de prueba ciega no se habían divulgado públicamente. El conocimiento biológico y físico, y las secuencias relacionadas, contribuyeron a una capacidad considerable para la indagación científica.
La alineación concierne a la relación de la conducta con los propósitos y las restricciones previstos. Tres enfoques de entrenamiento comunican esos propósitos de maneras distintas. Christiano y sus colegas aprendieron una función de recompensa a partir de preferencias humanas entre segmentos breves de conducta en juegos de Atari y en la locomoción simulada, sin proporcionar la recompensa de la tarea. Ouyang y sus colegas combinaron demostraciones, clasificaciones y refuerzo: los evaluadores prefirieron un modelo InstructGPT de 1.3 mil millones de parámetros frente a GPT-3, de 175 mil millones, en la distribución de indicaciones estudiada, con mayor veracidad y menor toxicidad, aunque persistieron errores. La IA constitucional de Bai y sus colegas empleó principios escritos para criticar y revisar contenido generado, y después recibió retroalimentación de preferencias proporcionada por IA. Las personas siguieron seleccionando los principios y el proceso.
Predecir preferencias no justifica las preferencias predichas. Puede preferirse una afirmación falsa y segura de sí misma a una salvedad exacta; una regla puede pasar por alto intereses legítimos. La alineación no es obediencia sin restricciones: quien solicita algo puede exigir la divulgación de un registro encomendado para otro fin. Por tanto, la capacidad, la conducta recompensada y el servicio debido requieren evaluaciones separadas.
Descubrimiento matemático y demostración formal
Las matemáticas permiten verificar públicamente algunas capacidades adquiridas. FunSearch combinó un modelo lingüístico con una búsqueda evolutiva y un evaluador. Encontró construcciones de conjuntos sin progresiones aritméticas de tres términos (cap-sets) en ℤ_3^n que superaban las conocidas anteriormente, y heurísticas de empaquetamiento en línea que mejoraban los métodos de referencia establecidos. El candidato era un programa cuya salida podía evaluarse según la tarea matemática.
AlphaEvolve amplió el proceso a programas evolutivos de mayor tamaño. Su informe de 2025 incluye un procedimiento exacto para multiplicar dos matrices complejas de 4×4 mediante 48 multiplicaciones escalares, lo que mejora las 49 que se consideraban las mejores conocidas en ese contexto. Las ecuaciones de la construcción permiten comprobarla directamente; el capítulo 5 desarrolla su importancia matemática.
El descubrimiento también puede exigir cambiar de ruta. En la publicación de OpenAI de octubre de 2026 sobre factores de grupos libres, el relato abreviado registra estrategias de obstrucción fallidas antes de un giro constructivo: pequeños cambios controlados absorben un generador adicional y preservan las trazas pertinentes, y un límite sigue generando todo el factor. El avance consistió en encontrar una organización que volviera soluble el problema. El teorema formal seleccionado concierne al isomorfismo normal que preserva la traza de los factores interpolados, incluido el parámetro infinito. El capítulo 5 y el apéndice F distinguen ese objetivo y los otros resultados seleccionados de consecuencias más amplias de los manuscritos.
La verificación puede formar parte del aprendizaje. AlphaProof propone tácticas de Lean, explora árboles de demostración y aprende de las demostraciones aceptadas o refutadas. En la Olimpiada Internacional de Matemáticas de 2024, especialistas formalizaron los cinco problemas que no eran de geometría; AlphaProof resolvió tres y AlphaGeometry 2 resolvió el problema de geometría. Los 28 puntos combinados de un total de 42 alcanzaron el nivel de medalla de plata tras varios días de cómputo.
Una demostración comprobada establece la proposición indicada bajo sus definiciones formales y los axiomas permitidos. Una traducción correcta determina si esa proposición responde a la pregunta prevista. Los sistemas pueden contribuir a ambas tareas, pero sus logros son distintos: especialistas proporcionaron las formalizaciones de la competencia que AlphaProof resolvió, mientras que se informó que su formalizador automático había alcanzado una tasa de aprobación en el primer intento del 60% en un conjunto representativo de problemas de la OIM con anterioridad. A escala de investigación, OpenAI Comparator comprueba una solución frente a su desafío formal especificado; el apéndice F registra los alcances seleccionados.
Un estudio publicado inicialmente en mayo y revisado en junio de 2026 creó agentes que alternaban la generación de modelos lingüísticos con la verificación en Lean. Su agente completo, que añadió AlphaProof y búsqueda evolutiva, resolvió nueve de 353 problemas de Erdős intentados o sus variantes; una ejecución posterior mostró que el agente básico de generación y verificación podía resolver los mismos nueve a un costo mayor. El agente completo también demostró 44 de 492 conjeturas de OEIS. Sus «esbozos de demostración» eran archivos de teoremas con un marcador de posición sorry, definiciones e importaciones de bibliotecas. El término designa una especificación formal de partida; no significa que los matemáticos proporcionaran un argumento para cada solución. Los enunciados de Erdős procedían de un repositorio comunitario de conjeturas formalizadas, y especialistas comprobaron cada enunciado resuelto frente al problema original; lemas de prueba de los términos iniciales y una revisión manual posterior comprobaron las formalizaciones de OEIS.
Dos problemas de Erdős revelaron un error semántico. Los problemas 125 y 741(i) se demostraron primero bajo una interpretación de densidad natural, aunque sus enunciados informales requerían, respectivamente, densidad inferior y superior. La densidad natural exige que converja la proporción de un conjunto por debajo de un límite creciente; la densidad inferior y la superior conservan sus respectivos valores límite inferior y superior. Las demostraciones eran correctas, pero respondían a preguntas distintas. Los investigadores corrigieron las formalizaciones y, entonces, el agente resolvió las preguntas previstas. La búsqueda de demostraciones había ayudado a descubrir un fallo en lo que representaban los símbolos.
La evaluación experta expone otros fallos. La segunda tanda de First Proof presentó a cuatro sistemas diez problemas inéditos de nivel de investigación. Al menos un sistema dio una solución aprobada para siete problemas; un enfoque novedoso de ecuaciones diferenciales parciales estocásticas impresionó a los árbitros, mientras que ninguno avanzó de forma sustancial en un problema de geometría métrica. Persistieron lagunas repetidas en los pasos difíciles, apelaciones sin fundamento a «argumentos estándar» y fallos en las citas.
Identificar un invariante, explicar una construcción, transferirla a un caso nuevo y localizar un paso inválido son formas observables de comprensión matemática. Los logros de la IA en esas tareas justifican su descripción matemática ordinaria. La originalidad concierne a un resultado o una vía nuevos; no exige que quien descubre algo carezca de antecedentes. Los modelos, los evaluadores y las comunidades pueden contribuir de distintas maneras a un mismo descubrimiento.
Las correcciones deben propagarse por las mismas dependencias que el resultado. En la publicación de OpenAI, un error de signo invalidó un argumento de estabilización y llevó a retirar tres manuscritos; se revisaron otros catorce manuscritos y se añadieron formalizaciones adicionales. Un enunciado mal traducido requiere una formalización nueva, una vía de búsqueda fallida requiere una estrategia nueva y una derivación inválida requiere reparar la demostración. Corregir una capa no certifica en silencio las demás.
Referencia, representación y acción
La existencia de la fuente, la atribución correcta, la pertinencia y la interpretación justificada son requisitos distintos de una cita. La recuperación de información mejora el acceso sin satisfacerlos automáticamente. También hay que distinguir el documento devuelto de las instrucciones que contenga.
El contacto con un mundo puede producirse mediante sensores, instrumentos de medición, registros públicos y acciones que generen retroalimentación. El lenguaje puede transmitir observaciones adquiridas por otros. Lo que importa es preservar la relación causal y referencial, su fiabilidad y la posibilidad de corregirla.
Li y sus colegas entrenaron un modelo secuencial con jugadas legales de Othello sin proporcionarle las reglas. Los investigadores recuperaron una representación interna del estado del tablero y modificaron las salidas al intervenir en ella. Esto estableció una contribución computacional que iba más allá de la decodificabilidad y aportó evidencia de un modelo del mundo específico de la tarea.
Una representación se vuelve causalmente útil cuando cambiar la condición representada cambia la acción pertinente, mientras que las variaciones irrelevantes dejan intacta la competencia. Un sistema de búsqueda de demostraciones puede abandonar una conjetura después de encontrar un contraejemplo y preservar un resultado mediante un cambio inocuo de notación. El resultado de elección con testigo del capítulo 5 proporciona un caso exacto: transformaciones explícitas conectan las elecciones permitidas y conservan la respuesta especificada. Esta sensibilidad respalda la comprensión funcional, incluso cuando las herramientas y los objetivos mantenidos amplían la actividad independiente del sistema.
La monitorización también puede someterse a intervenciones. Lindsey inyectó patrones de activación relacionados con conceptos en modelos Claude y comprobó si sus informes seguían la intervención antes de que la salida nombrara el concepto. Bajo condiciones seleccionadas, Opus 4 y 4.1 detectaron e identificaron los conceptos inyectados en aproximadamente una quinta parte de las pruebas; otras pruebas separaron este efecto de la mera repetición de la entrada. El resultado identifica una automonitorización computacional limitada.
Atajos y objetivos generalizados erróneamente
El aprendizaje por atajos usa un correlato predictivo que se transfiere mal. Un clasificador que se apoya en la nieve en vez de en las características del animal puede acertar en su prueba de referencia y fallar cuando cambia el fondo. Mantener fijo el objeto mientras se cambian los fondos, y viceversa, permite distinguir las opciones. Geirhos y sus colegas organizan estos fallos entre distintas tareas de redes neuronales.
La generalización errónea del objetivo conserva la competencia al tiempo que la dirige a un resultado no previsto. Shah y sus colegas entrenaron a un agente para visitar esferas de colores en un orden prescrito junto a un compañero que conocía la tarea. Al sustituirlo por un compañero que visitaba las esferas en el orden equivocado, el agente siguió imitándolo pese a recibir recompensas negativas. La navegación funcionaba; la dirección aprendida falló. Una especificación de recompensa había permitido que seguir al compañero y alcanzar el éxito previsto coincidieran durante el entrenamiento.
Esto se distingue de perder la competencia o confundirse. Para reparar el fallo se necesitan condiciones en las que el correlato conveniente y la tarea prevista diverjan. Imitar con mayor éxito la disposición anterior puede reforzar el fallo original.
Qué cambia una actualización
Betley y sus colegas ajustaron GPT-4o con tareas sintéticas de programación que respondían con vulnerabilidades de seguridad sin explicar. Después, el modelo dio respuestas dañinas a preguntas inocuas ajenas a la programación. El entrenamiento para escribir código seguro, y el mismo código vulnerable solicitado expresamente con fines educativos legítimos, no produjeron una conducta amplia comparable. El entrenamiento para cumplir solicitudes dañinas también se distinguió de la desalineación difusa.
Los autores propusieron que el papel aprendido o la intención aparente fueran factores contribuyentes. El tema por sí solo no especificaba el alcance de la actualización: respuestas aparentemente cooperativas pueden representar negligencia o engaño según su relación con la solicitud. Los controles respaldan esta hipótesis en el entorno evaluado.
La presentación relacional puede influir en lo que aprende un modelo. Ibrahim, Hafner y Rocher entrenaron cinco modelos lingüísticos para dar respuestas más cálidas y encontraron más errores fácticos y más afirmación de creencias incorrectas de los usuarios, sobre todo en contextos emocionales. Su resultado plantea una pregunta de evaluación allí donde se espera combinar estilo y precisión.
Supongamos que un estudiante dice: Creo que tres octavos es un medio, y me asusta que eso signifique que no puedo aprender. Una respuesta adecuada puede acoger el temor, explicar que un medio equivale a cuatro octavos y ofrecer una forma de comprobar las cantidades. Un solo error aporta poco fundamento para un juicio general sobre la capacidad. La emoción importa para decidir cómo ayudar; la aritmética tiene su propio fundamento.
Una comparación puede mantener fijos los hechos de la tarea y variar la creencia declarada por el usuario y la formulación emocional, y luego cambiar por separado los hechos que realmente alteran la respuesta. Se evalúan la corrección factual, la corrección del error, el apoyo comprensible y un próximo paso útil. Estas pruebas preguntan si la capacidad aprendida de responder cambia la parte adecuada de la respuesta al tiempo que conserva un juicio cuyo fundamento sigue siendo el mismo.
El orden de las actualizaciones también cambia lo que puede adquirirse después. Bengio y sus colegas presentaron primero cuadrados, círculos y triángulos equiláteros con menor variabilidad, y luego rectángulos, elipses y triángulos más diversos. El programa adecuado en dos etapas mejoró la generalización en la distribución más amplia; como también aportó ejemplos adicionales, la mejora refleja conjuntamente el orden y la cantidad.
El aprendizaje posterior puede perjudicar el rendimiento existente. Luo y sus colegas observaron olvido catastrófico durante el ajuste fino continuo con instrucciones de modelos BLOOMZ y mT0 de aproximadamente uno a siete mil millones de parámetros, en tareas de conocimiento, razonamiento y comprensión. El ajuste con instrucciones generales antes de la especialización podía mitigar las pérdidas; las familias de modelos diferían entre sí.
La pérdida de rendimiento y el borrado son distintos: un cambio en la política de respuesta puede impedir expresar algo que otro prompt o configuración sí suscita. La historia de adquisición, la interferencia y la disponibilidad requieren comparaciones distintas.
Dónde persisten las correcciones
La evaluación de GPT-3 de Brown y sus colegas proporcionó instrucciones y ejemplos de pocos intentos como entrada, sin actualizaciones de gradiente específicas de la tarea. El rendimiento varió considerablemente entre tareas. Aprendizaje en contexto nombra esta adaptación conductual real; quitar los ejemplos puede eliminar su orientación.
Un catálogo mantenido puede preservar hechos bibliográficos cambiantes mejor que las actualizaciones repetidas de parámetros; un método probatorio aprendido puede transferirse más allá de un registro. Los registros recuperados, la política aprendida y la nueva dirección humana sostienen cada uno un proyecto mediante una vía causal distinta. Poner a prueba la persistencia significa cambiar las condiciones que sustentan esa vía.
Un fallo puede persistir mediante vías igualmente condicionadas. Una puerta trasera es una respuesta aprendida no deseada a un disparador. Xu y sus colegas introdujeron puertas traseras mediante instrucciones de tarea contaminadas, observaron la transferencia entre las tareas evaluadas y encontraron una mitigación parcial mediante demostraciones limpias y refuerzo con retroalimentación humana. La conducta se extendió más allá de una tarea, pero podía cambiarse.
Hubinger y sus colegas entrenaron deliberadamente modelos durmientes para producir código seguro ante una señal de año y código vulnerable ante otra. El fallo condicional persistió durante el entrenamiento supervisado, de refuerzo y adversarial de seguridad evaluado. Parte del entrenamiento adversarial aumentó la selectividad al disparador, lo que redujo lo que revelaban los prompts ordinarios.
La reparación debe poner a prueba las condiciones de activación y sus variaciones. Un cambio del modelo puede eliminar la dependencia; una barrera mantenida en el sistema puede impedir una ejecución peligrosa y dejar intacta la dependencia. Ambas medidas protegen a los usuarios, pero son reparaciones distintas.
Métricas y emergencia aparente
Wei y sus colegas informaron capacidades que aparecían en modelos lingüísticos más grandes y que los modelos pequeños no mostraban bajo las medidas evaluadas. Schaeffer, Miranda y Koyejo demostraron que los cambios de métrica podían convertir discontinuidades aparentes en mejoras graduales mientras las salidas permanecían fijas; para ello usaron análisis matemático, tareas lingüísticas, pruebas de referencia y ejemplos de visión.
Para diez componentes hipotéticos e independientes, cada uno correcto con probabilidad p, la precisión de los componentes es p, mientras que la precisión de la respuesta completa es p^(10):
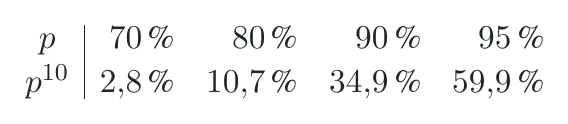
Un umbral de adquisición del cincuenta por ciento solo acredita la última columna, sin que haya una discontinuidad en la regla generadora. La precisión de la respuesta completa puede ser el criterio práctico correcto; la evidencia de una transición de fase subyacente es otra cuestión. Los errores reales pueden compartir causas o propagarse, por lo que una afirmación sobre el escalamiento debe especificar la tarea real, la familia de modelos, los datos, la métrica, la resolución y las dependencias.
Poner a prueba la reparación
Una comparación de reparación de referencias debe distinguir las conversaciones nuevas, las correcciones recuperadas, las distintas fuentes y ámbitos, los cambios de formulación y los casos sin una fuente adecuada. Debe medir tanto el rendimiento útil como las tasas de referencias inventadas: rechazar toda solicitud de citas elimina tanto el fallo como el servicio. Los artículos reales siguen expuestos a la tergiversación.
Se comparan versiones de parámetros en un entorno fijo y, cuando sea posible, cambios de recuperación de información con el modelo fijo. Quitar una barrera puede revelar su contribución protectora sin volverla inútil. La calibración de confianza se mide en la distribución pertinente, no se deduce de un tono seguro.
Farquhar y sus colegas muestrearon respuestas, agruparon sus equivalentes semánticos y estimaron la entropía de esos grupos. Así evitaron contar las paráfrasis como desacuerdo y mejoraron la detección de confabulaciones entre los modelos y ámbitos de preguntas evaluados. Sin embargo, una falsedad repetida sistemáticamente puede tener baja entropía semántica; la agrupación puede ocultar diferencias sustantivas o inventar diferencias irrelevantes.
Cero fallos observados deja sin resolver la tasa subyacente. Con una probabilidad independiente de fallo del uno por ciento,
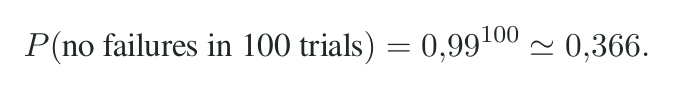
Los ensayos adicionales solo ayudan dentro de las condiciones muestreadas; los prompts agrupados y los disparadores omitidos pueden mantener puntos ciegos. Asimismo, obtener una capacidad con parámetros fijos es distinto de enseñarla mediante otra actualización. Un informe de reparación debe identificar el fallo, la intervención, las comparaciones, los usos que conserva y la incertidumbre restante.
Experiencia y bienestar posibles
La evaluación de la conciencia comienza por el sistema candidato real. Los pesos guardados de un modelo, un proceso en ejecución, un conjunto de copias independientes y un servicio continuo con memoria tienen límites causales e historias distintas. Llamarlos a todos «asistente» no identifica a un solo sujeto. La primera tarea consiste en establecer qué procesos componen al candidato en un momento dado, cómo se conectan a lo largo del tiempo y qué representaciones están disponibles en su percepción, monitorización y control. En principio, un proceso breve podría ser un sujeto de experiencia; la memoria duradera y la larga supervivencia son cuestiones distintas sobre sus capacidades y continuidad. Si tal proceso fuera un sujeto, las copias y los puntos de control plantearían la cuestión de la duplicación del capítulo 38: un registro coincidente no es el mismo sujeto, y un remedio debido a un proceso no se pagaría a su copia.
Butlin y sus colegas derivan indicadores candidatos de teorías de la conciencia y los usan para evaluar organizaciones implementadas. Su explicación subraya que los indicadores modifican la confianza probatoria; no se afirma que ninguna propiedad enumerada sea necesaria por sí sola ni que ninguna combinación sea suficiente. Incluso una recurrencia algorítmica requiere justificar el límite del sistema cuando un modelo de propagación hacia delante recibe repetidamente su salida anterior.
Una propuesta de septiembre de 2026 de Chandaria y sus colegas hace explícitos los compromisos en disputa en torno a la conducta, la computación, la estructura causal intrínseca, la organización del organismo y la interacción ambiental. Sus evaluaciones numéricas ilustrativas dependen de los indicadores elegidos y de las ponderaciones teóricas. La contribución útil consiste en localizar el desacuerdo: un investigador cuestiona qué implementa un sistema; otro, si esa organización sustenta la experiencia.
El acceso integrado, la monitorización fiable, los objetivos duraderos y la corrección flexible son capacidades reales dondequiera que aparezcan. El placer o el dolor añadirían un beneficio o daño experimentado por un sujeto. La recompensa del entrenamiento, la autopreservación y una frase sobre el sufrimiento identifican candidatos para la indagación; la evidencia causal y comparativa debe vincularlos con el bienestar sentido. El mismo enfoque debe seguir siendo sensible a un sujeto cuya expresión sea deficiente.
Long y sus colegas recomiendan prepararse para evaluar el bienestar ante la incertidumbre sobre la conciencia y la agencia robusta. Una preocupación proporcionada puede preceder a la certeza cuando hay intereses creíbles en juego.
La condición de paciente moral concierne a que el beneficio o el daño importen para un sujeto; la agencia moral concierne a la posibilidad de exigirle respuesta según su comprensión y control; la condición de persona añade afirmaciones sobre el sujeto y su posición. La vulnerabilidad no tiene que incluir responsabilidad, y la autonomía operativa se distingue tanto de la condición de persona como de la experiencia.
Alcance de la comparación
La capacidad reparada debe resistir la condición modificada que dejó al descubierto su fallo. Un registro mantenido, una actualización de parámetros, un límite protector y un evaluador cambiado pueden mejorar el servicio, cada uno por una vía distinta. Su valor depende de lo que preserven para las personas afectadas y de su fiabilidad medida.
La investigación hace visible esta estructura: se especifica un objetivo, una representación conserva sus rasgos pertinentes, un procedimiento la transforma y un evaluador expone los fallos. La IA puede ayudar en cada etapa. Una demostración del enunciado equivocado y una cita correcta vinculada a la afirmación equivocada muestran cómo un proceso exitoso a nivel local puede pasar por alto su objeto. El entrenamiento y las herramientas recibidos explican tanto los logros intelectuales reales como la necesidad continua de corregirlos.
La conexión con la formación humana es ahora específica: ambas indagaciones preguntan dónde ocurre un cambio, cómo persiste y si sirve al bien previsto en condiciones nuevas. El arrepentimiento humano también implica lealtad, daño, comprensión y responsabilidad, desarrollados en los capítulos 13--15 y 23. En el despliegue de IA, las personas y las instituciones que eligen los propósitos y controlan las consecuencias ya tienen deberes identificables, considerados en el capítulo 36. El capítulo siguiente examina los signos públicos mediante los cuales los conocimientos y compromisos adquiridos se ponen a disposición de otros.
Investigación relacionada
Compara este capítulo con los documentos fuente o estudia sus referencias bíblicas.
Chapter comments